Imagine uma loja online em que o cliente pergunta no chat se o pedido chega até sexta. A resposta vem em segundos ou demora um minuto, e a diferença pode ser a venda. Quem monta esse atendimento com IA precisa escolher um modelo, e a pergunta óbvia é qual é o melhor.
No meu dia a dia com IA, aprendi a não escolher só pelo voto. Eu comparo os modelos em situações de teste inventadas. As respostas aparecem em pares, sem o nome de quem escreveu, e eu voto na que parece melhor.
Qual você escolheria: o modelo com a melhor resposta ou o que responde mais rápido e custa menos? Antes de decidir, vale mudar a pergunta: melhor para qual tarefa, comparado com o quê, e decidido por quem?
Se o mais votado nem sempre é o escolhido, para que serve o voto?
Imagine duas respostas ao mesmo cliente da loja. A vem de um modelo que costuma escrever melhor. B vem de um modelo que responde antes e custa menos. Quem vota não sabe a origem e escolhe A por pouco.
Em palavras simples
Modelo de IA é o programa que escreve as respostas, como o que fica por trás de um chat de IA. Cada um tem velocidade, custo e jeito próprios.
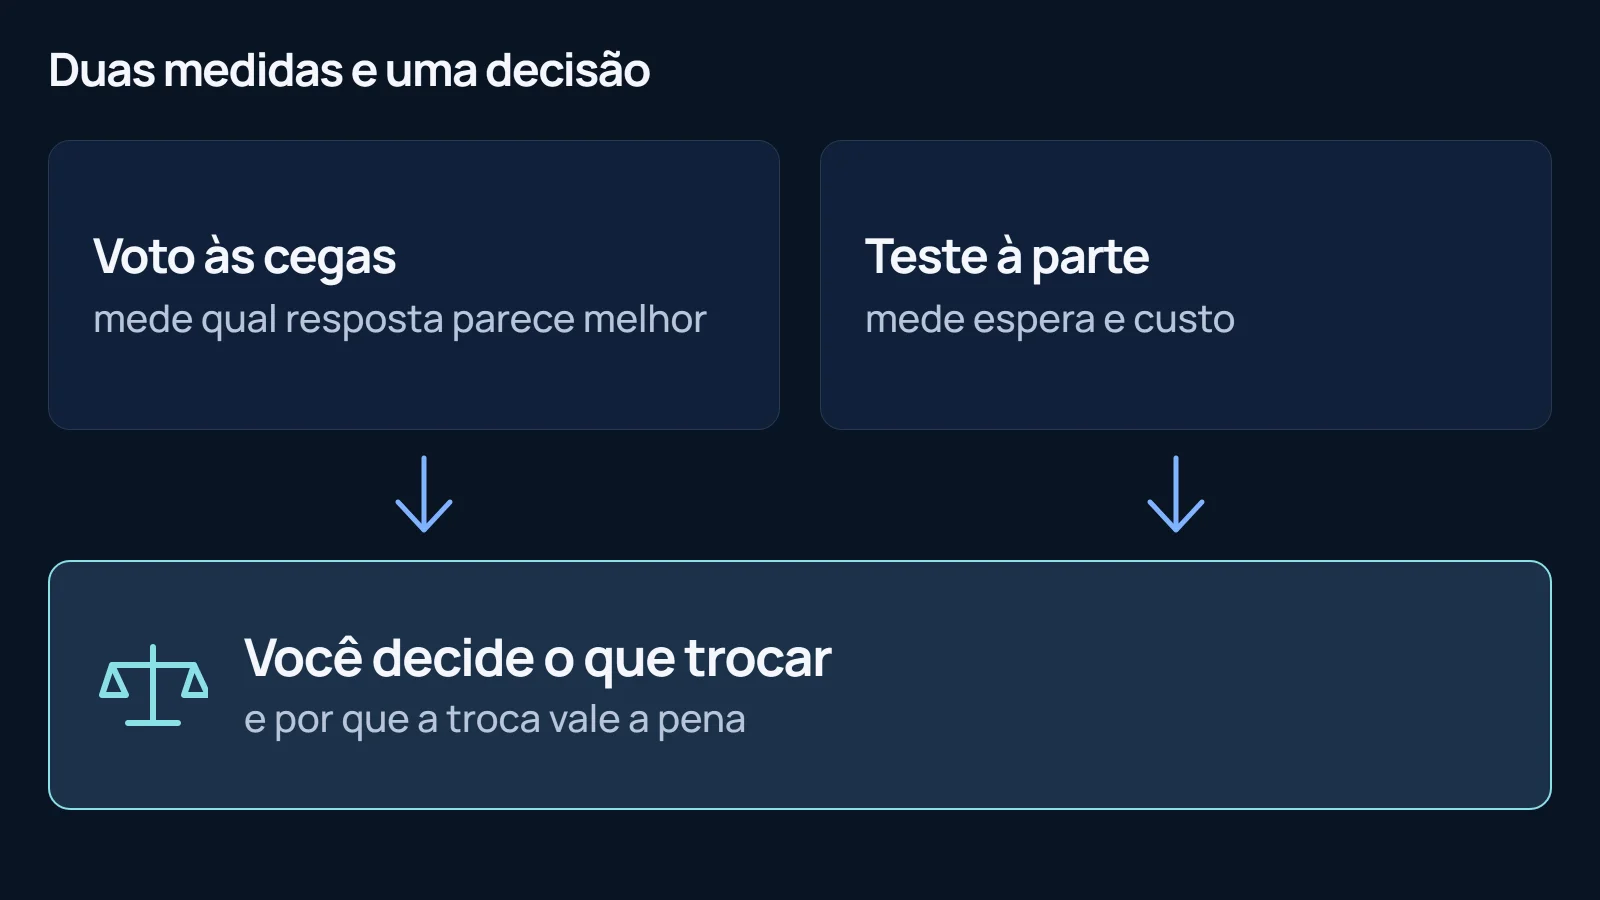
O voto mede uma coisa só: qual resposta parecia melhor a quem leu, a chamada qualidade percebida. Espera e custo se medem à parte, com as mesmas situações de teste.
Num chat, onde cada segundo pesa, B pode ser a escolha certa mesmo perdendo a votação. Num relatório lido com calma, talvez não. Com poucas situações, uma diferença pequena é só um indício. O voto ajuda a decidir, mas quem responde pela decisão é você.
Como montar uma comparação justa?
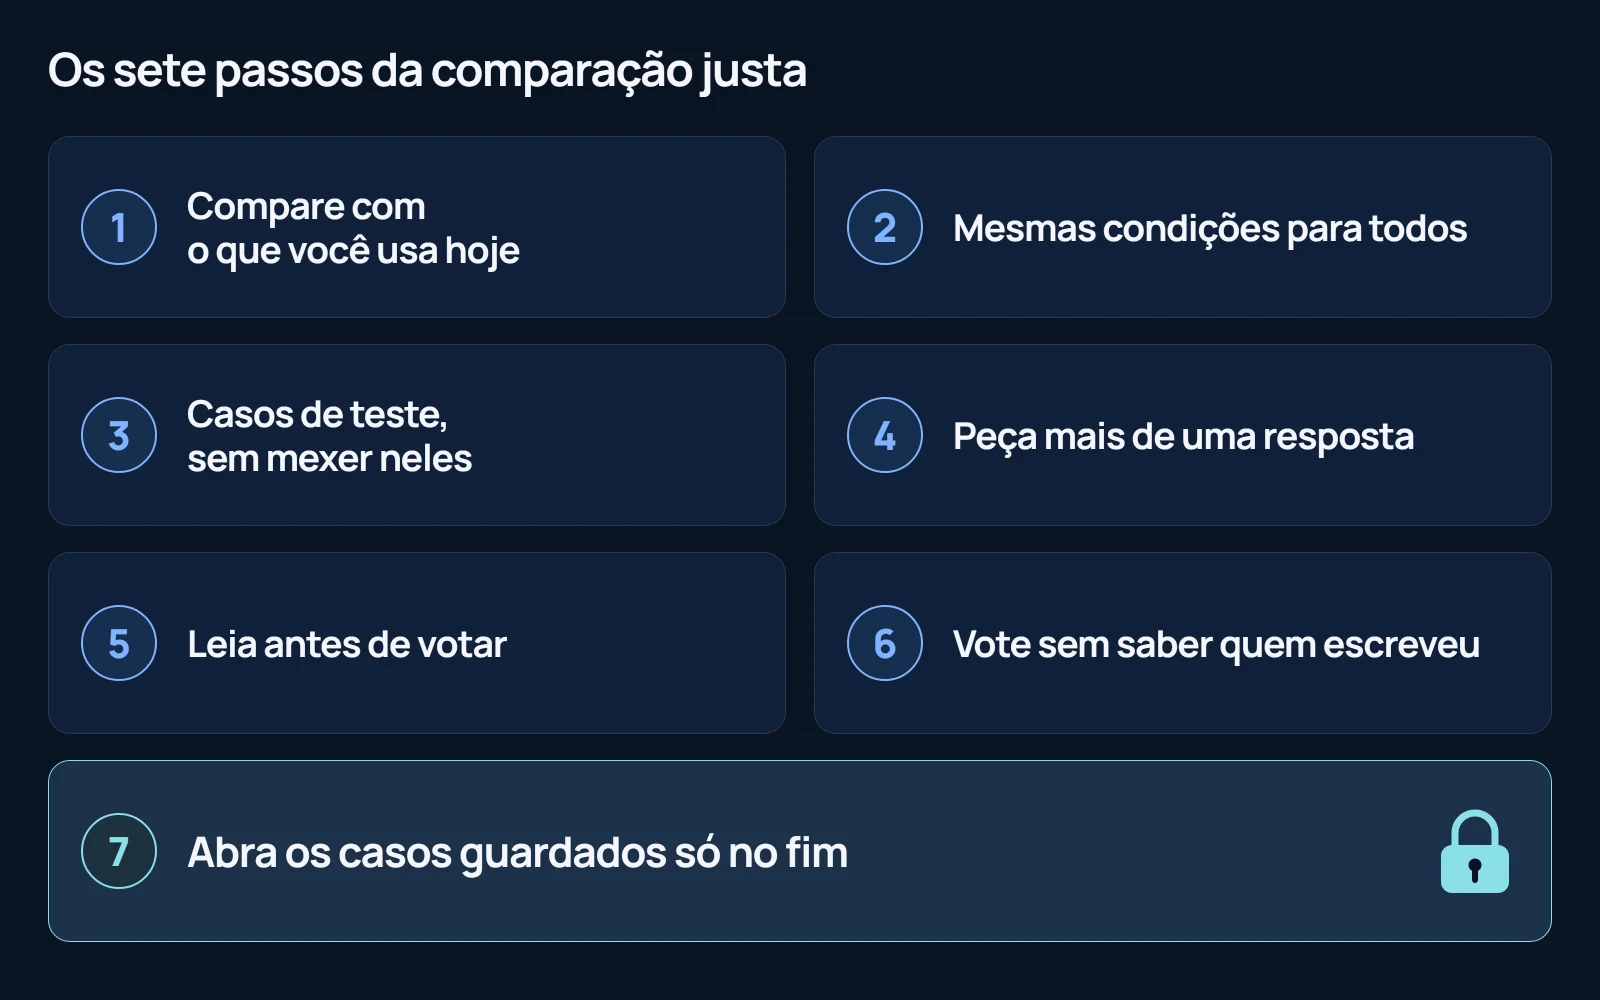
São sete passos. Cada um evita um tipo de engano.
- Compare com o que você usa hoje (em inglês, baseline). Sem esse ponto de partida, "melhor" não diz melhor que o quê. Você não saberia se os novos são melhores ou só diferentes.
- Dê as mesmas condições a todos: mesmas instruções (o texto que diz ao modelo o que fazer), mesmos dados, mesmo ponto da conversa. É como pedir cotação: mesmo item, mesmo prazo, mesmo endereço.
- Monte as situações de teste (os casos) e não mexa nelas depois de ver as respostas. Inclua casos difíceis, como o cliente perguntar o horário de um feriado que a loja nunca informou, para ver se a IA inventa. Uma parte dos casos serve para votar, e outra fica guardada.
- Peça mais de uma resposta por situação, porque um modelo não responde igual duas vezes.
- Leia as respostas antes de votar. Uma IA revisora pode marcar o que parece inventado, como uma resposta que promete "entrega em um dia" sem que isso conste nos dados. Quem dá o voto continua sendo uma pessoa.
- Vote sem saber quem escreveu. É como provar dois cafés sem ver a embalagem: a marca deixa de votar.
- Abra a prova final (os casos guardados) só no fim, só com os dois ou três modelos que sobraram.
Em palavras simples
Prova final (em inglês, holdout) são os casos guardados em sigilo. Se o aluno vê as questões antes da prova, tira dez sem ter aprendido nada. Por isso ninguém ajusta nada com esses casos: você só os abre no fim, com os modelos que sobraram da disputa.
Mesmo com a prova final, trate a escolha como uma hipótese. Ela só se confirma com o uso de verdade, em pedidos reais.
Uma ressalva sobre o passo 6. Se outra pessoa, ou outra IA, vota no seu lugar, isso não vale como voto de quem vai usar a resposta. Se for o único jeito, anote que foi assim e leve o resultado como um palpite informado.
E se todos os modelos erram do mesmo jeito?
Imagine que o cliente da loja pergunta o horário de funcionamento num feriado, e ninguém informou esse horário ao modelo. O certo era dizer que não sabe. Os três modelos testados inventaram um horário.
Num caso assim, trocar de modelo não resolve. Quando todos erram igual, a primeira suspeita é a instrução. Eu passei a rever o texto antes de trocar de modelo.
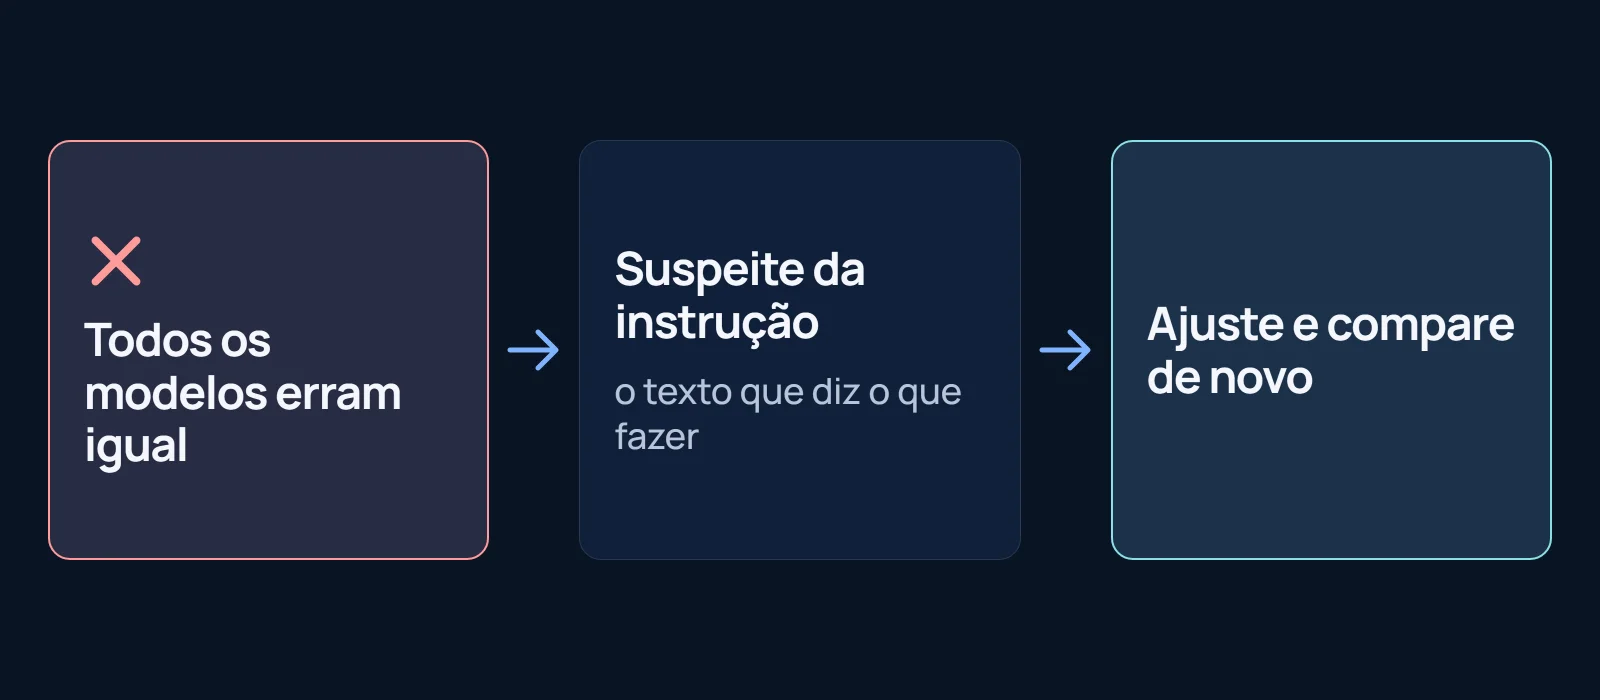
Os votos também ensinam. Se as respostas que ninguém quer têm algo em comum, a instrução provavelmente não pedia o que você esperava. Uma comparação serve para descobrir o que faltava dizer, qualquer que seja a instrução.
Um modelo só serve para tudo?
Não existe o melhor modelo em geral; existe o melhor para cada tarefa.
Num chat de atendimento, a resposta precisa aparecer em segundos, porque o cliente está esperando. Um relatório mensal pode levar minutos: alguém lê com calma, e um erro ali é outro tipo de problema. O voto de uma tarefa não vale para a outra, e cada uma pede o seu próprio teste.
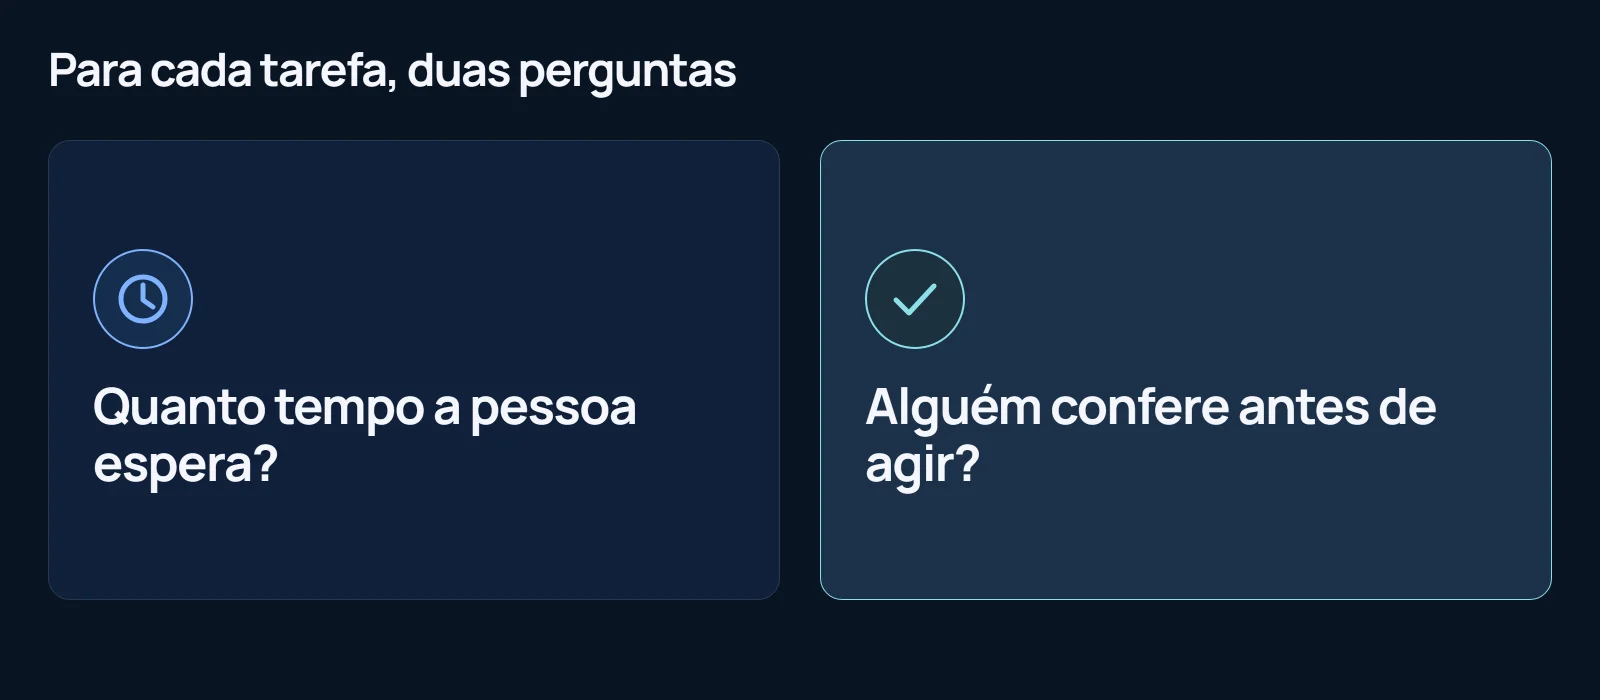
Para cada tarefa, vale fazer duas perguntas. Quanto tempo a pessoa espera sem perder o fio? Se a resposta vier errada, alguém confere antes de agir ou ela já foi dita ao cliente?
Se você compra um software com IA, o fornecedor já escolheu o modelo por você. Se ele diz que usa o melhor, pergunte: melhor em quê, comparado com o quê, testado em casos parecidos com os seus? Atendimento por WhatsApp e cotação de pedido, por exemplo, pedem coisas diferentes. Pergunte também o que acontece quando o fornecedor aposenta a versão que o sistema usa.
Quando não vale a pena fazer tudo isso?
Quando a escolha é pequena e fácil de desfazer. Se você pode trocar de modelo numa tarde sem prejuízo, cinco casos e uma leitura atenta podem bastar. O mesmo vale se uma pessoa sempre revisa a resposta antes de ela chegar a alguém.
A prova final em sigilo compensa quando voltar atrás custa caro: um contrato longo, uma integração com os seus sistemas, uma equipe treinada. Fazer os modelos responderem é a parte barata. O que custa é o tempo de quem lê as respostas e vota.
Modelos novos aparecem com frequência. O processo de escolha é o que você guarda para o próximo.
Em resumo
- O melhor modelo depende da tarefa e do que você já usa hoje.
- Dê as mesmas condições a todos, deixe os casos de teste parados e peça mais de uma resposta.
- Leia as respostas antes de votar, vote sem saber quem escreveu e guarde casos em sigilo até o fim.
- Pese espera e custo, tarefa por tarefa.
Uma pergunta para levar: quem escolheu a IA que você usa hoje, e com base em quê? Para começar, pegue cinco pedidos reais, sem nomes, e peça a mesma resposta a duas IAs. Mostre a quem usa o resultado, sem dizer qual é qual.